Validated AI: predtestované AI zostavy pre reálnu prevádzku
• Autor: Peter Vnuk
Dve AI zostavy s rovnakým typom akcelerátora môžu v reálnej prevádzke fungovať veľmi odlišne. Predtestovaná konfigurácia pomáha ešte pred nákupom overiť kompatibilitu, skutočný výkon aj limity konkrétneho workloadu a obmedzuje riziko drahého ladenia po dodaní hardvéru.
- Validated AI: predtestovaná zostava namiesto nákupu naslepo
- Čo vlastne znamená „validovaná“
- Ako spoznať slabú „validáciu“
- Rovnaký typ GPU môže podávať odlišný AI výkon
- Softvér môže rozhodnúť skôr ako samotný hardvér
- Kompaktná AI stanica môže prevziať vývoj aj pravidelnú lokálnu prácu
- Vyššia trieda prichádza s väčšími modelmi a náročnejšou prevádzkou
- RAG ukazuje, prečo sa má validovať celý workload
- Meraný výkon potrebuje popísané podmienky
- Kde predtestovaná zostava šetrí čas a znižuje riziko
Validated AI: predtestovaná zostava namiesto nákupu naslepo
Pri nákupe AI infraštruktúry zvádzajú k rýchlemu porovnaniu hlavne počty GPU, kapacita pamäte alebo výkon v PFLOPS. Z týchto parametrov sa však ťažko odhaduje správanie konkrétnej aplikácie. Firmu vo výsledku zaujíma, za ako dlho začne systém odpovedať, koľko ľudí ho môže používať súčasne a či vybraný model zvládne potrebný kontext. Nemenej dôležitý býva aj čas, ktorý technický tím strávi samotným sprevádzkovaním prostredia.
Z rozdielu medzi parametrami v datasheete a skutočnou prevádzkou vychádza koncept Validated AI. Konfigurácia sa tu posudzuje ako zladený celok, takže vedľa hardvéru vstupuje do hry operačný systém a softvérové prostredie pre prácu s modelmi. Pokročilejšia forma overenia pridáva aj konkrétny scenár použitia, napríklad lokálnu inferenciu, RAG nad firemnými dokumentmi, vývoj agentov alebo fine-tuning.
Čím viac test zodpovedá budúcej prevádzke, tým menší priestor zostáva pre nepríjemné prekvapenia po nákupe. Samotné označenie „AI pracovná stanica" hovorí predovšetkým to, do akej produktovej kategórie zostava patrí. Podrobná dokumentácia už môže popísať podporovaný softvér, veľkostnú triedu modelov aj limity vyplývajúce z pamäte a očakávaného spôsobu nasadenia.
Čo sa v článku dozviete:
- čo presne môže znamenať validovaná AI konfigurácia,
- prečo rovnaký typ GPU môže v praxi podávať odlišný výkon,
- akú úlohu hrá pamäť, operačný systém a celý AI stack,
- kedy sa hodí kompaktná AI pracovná stanica a kedy vyššia trieda infraštruktúry,
- podľa čoho posúdiť, či predtestovaná zostava zodpovedá skutočnému firemnému scenáru.
Čo vlastne znamená „validovaná“
Pod jedným pojmom sa v AI infraštruktúre skrýva niekoľko odlišných úrovní overenia, takže samotné slovo „validovaná“ ešte neposkytuje dosť informácií pre nákupné rozhodnutie.
- Certifikačný program obvykle kontroluje splnenie presne definovaných požiadaviek výrobcu.
- Referenčná architektúra popisuje odporúčanú skladbu systému a spôsob nasadenia.
- Predkonfigurovaná platforma spája konkrétny hardvér so známym softvérovým prostredím.
- Workloadová validácia pridáva praktický test s určeným modelom, aplikáciou alebo typom záťaže.
Konkrétnu podobu takéhoto overenia ukazuje program NVIDIA-Certified Systems, v ktorom systémy prechádzajú definovanými testami a hodnotením. Pri platforme Grace Blackwell GB10 patrí medzi validované konfigurácie napríklad ASUS Ascent GX10 a Dell Pro Max s GB10, ktoré NVIDIA výslovne uvádza vo svojom zozname certifikovaných systémov.
Z pohľadu firmy sú preto podstatné hlavne podmienky, pri ktorých overenie prebehlo. Výsledok má inú hodnotu, pokiaľ sa testoval iba samotný model, a inú vo chvíli, keď sa merala celá aplikácia. Dĺžka kontextu alebo počet paralelných požiadaviek navyše dokážu zmeniť správanie zostavy natoľko, že inak správny benchmark začne byť pre konkrétny projekt málo vypovedajúci.
Úrovne overenia AI konfigurácie
| Úroveň overenia | Čo typicky potvrdzuje | Praktický vplyv |
|---|---|---|
| Kompatibilita | Podporovanú kombináciu hardvéru, ovládačov a softvéru | Menšie riziko problémov pri inštalácii |
| Predkonfigurovaná platforma | Zladený hardvér, OS a AI stack | Rýchlejšia cesta k prvému pilotu |
| Referenčná architektúra | Odporúčanú konfiguráciu a spôsob nasadenia | Presnejší základ pre návrh infraštruktúry |
| Workloadová validácia | Správanie zostavy s konkrétnou úlohou alebo modelom | Lepší odhad výkonu a prevádzkových limitov |
| Certifikovaný systém | Splnenie pravidiel definovaného programu výrobcu | Jasnejšie vymedzená konfigurácia a podpora |
Ako spoznať slabú „validáciu“
Najrýchlejšie sa kvalita validácie pozná podľa toho, či je možné dohľadať konkrétne podmienky merania. Ak dokumentácia uvádza iba všeobecné označenie „AI-ready" alebo maximálny výkon v PFLOPS, zostáva väčšina praktických otázok bez odpovede. Zákazník stále nevie, aký softvér je podporovaný, pre aký typ úlohy bola konfigurácia pripravená a kde leží jej skutočný limit.
Rovnako dôležitá je podobnosť testu s plánovanou záťažou. Výsledok z krátkeho izolovaného testu môže v tímovej prevádzke rýchlo stratiť vypovedaciu hodnotu, pretože s rastúcou súbežnosťou a dĺžkou kontextu sa menia pamäťové nároky aj odozva. Hodnota testu preto rastie s tým, ako presne napodobňuje očakávanú prevádzku.
Varovné signály slabo doloženej validácie
| Varovný signál | Čo chýba | Čo overiť |
|---|---|---|
| Uvádza sa len maximálna PFLOPS alebo TOPS | Väzba na konkrétnu aplikáciu | Model, presnosť a podmienky merania |
| Zostava je označená ako AI-ready | Rozsah skutočného overenia | Podporovaný stack a cieľové workloady |
| Benchmark pracuje s krátkym promptom | Realistická dĺžka kontextu | Test s podobnými vstupmi ako v produkcii |
| Výsledok platí pre jedného používateľa | Správanie pri súbežnosti | Záťažový test s očakávanou špičkou |
| Softvér sa vyberá až po nákupe | Overená kompatibilita | Verzia OS, ovládačov, knižníc a runtime |
| Nikto nevie popísať limit zostavy | Kapacitný rámec | Pamäť, latencia a rast záťaže |
Rovnaký typ GPU môže podávať odlišný AI výkon
Keď sa test presunie od tabuľkových parametrov ku konkrétnej AI službe, začne sa oveľa viac prejavovať zvyšok systému. Jazykový model potrebuje v pamäti priestor pre svoje váhy a počas inferencie pribúdajú ďalšie nároky spojené s kontextom alebo obsluhou súčasných požiadaviek. Dlhšie dokumenty či vyšší počet používateľov preto môžu vyčerpať dostupnú rezervu skôr, než sa naplno prejaví teoretický výpočtový výkon akcelerátora.
Rovnako výrazne dokáže výsledok zmeniť softvér – iná verzia ovládača alebo inferencie enginu môže ovplyvniť rýchlosť aj stabilitu. Ďalšie rozdiely vznikajú podľa zvolenej kvantizácie alebo spôsobu práce s cache. Dve zostavy s podobným hardvérom sa preto môžu v tej istej aplikácii správať prekvapivo odlišne, pričom produkčná prevádzka navyše preverí dlhodobú záťaž, ktorú krátky benchmark často nezachytí.
Predtestovaná konfigurácia môže časť tejto neistoty znížiť ešte pred nasadením. Technický tím získava známy východiskový bod a vlastné testovanie môže sústrediť na firemné dáta, správanie konkrétnej aplikácie a záťaž počas reálnych prevádzkových špičiek.
Softvér môže rozhodnúť skôr ako samotný hardvér
V AI infraštruktúre predstavuje akcelerátor iba jednu vrstvu systému a nad ním pokračuje celý reťazec ďalších závislostí. Ovládače a systémové knižnice musia správne spolupracovať s frameworkom, inferencia runtime aj nástrojmi pre správu modelov. Chyba v ktorejkoľvek časti môže projekt oneskoriť ešte pred prvým použiteľným testom alebo znížiť výkon, ktorý firma z drahého hardvéru skutočne dostane.
Pre menšie tímy býva pripravený AI stack cenný najmä vo chvíli, keď chcú rýchlo overiť prvé use case. Týždne strávené skladaním základného prostredia majú vlastnú cenu, pretože rovnaký čas mohol vývojársky tím venovať integrácii alebo práci na samotnej aplikácii.
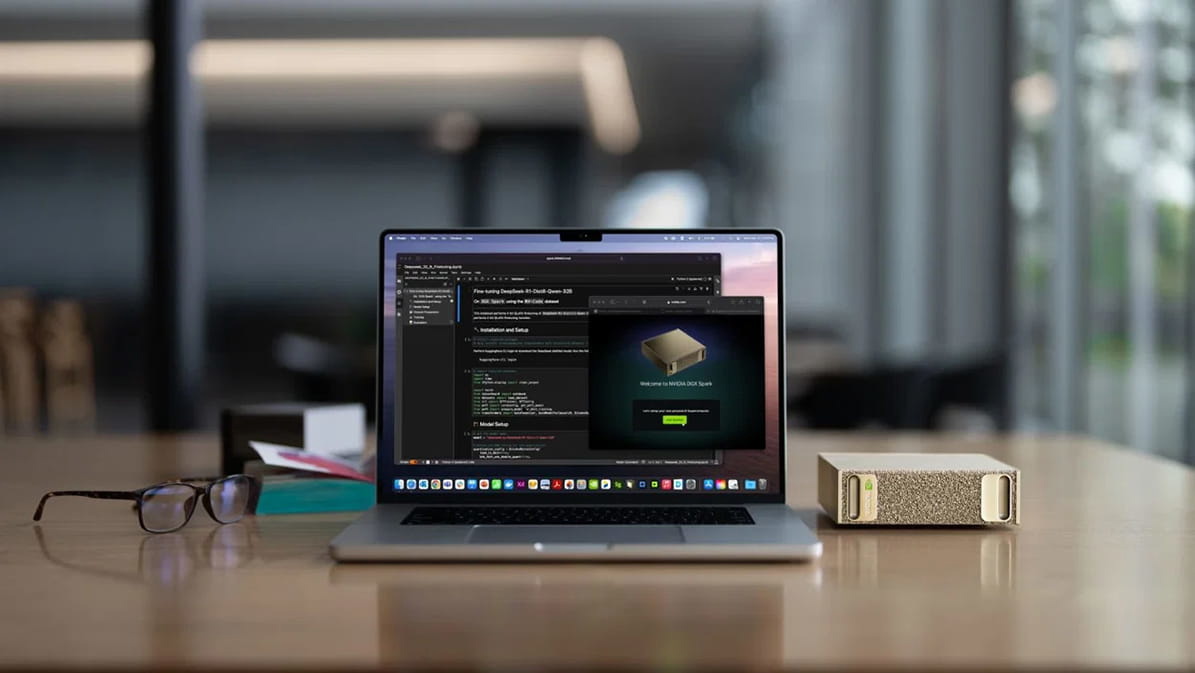
Konkrétnu podobu takého zladenia je možné ukázať na kompaktných systémoch s NVIDIA GB10 Grace Blackwell. NVIDIA DGX Spark 4TB, už spomínaný Dell Pro Max s GB10 FCM1253 alebo ASUS Ascent GX10 kombinujú danú platformu s pripraveným softvérovým prostredím pre vývoj a lokálnu prácu s AI. Pri samotnej platforme DGX Spark NVIDIA uvádza 128 GB zjednotenej pamäte, výkon až 1 PFLOP pri FP4 a podporu modelov do 200 miliárd parametrov.
Význam týchto parametrov sa ukáže až v konkrétnom nasadení, pretože rovnaká platforma môže počas vývoja slúžiť inak ako pri pravidelnej lokálnej inferencii. Spôsob využitia potom rozhodne, či zostava zostane prostredím pre pilot, alebo prevezme aj časť dlhodobej práce tímu.
i
Čo má byť o predtestovanej platforme transparentne zdokumentované
Pred nákupom by mala byť známa presná hardvérová konfigurácia, podporovaný operačný systém a verzia kľúčových softvérových vrstiev. Výkonové výsledky potrebujú obdobný kontext: bez informácie o použitom modeli, presnosti a charaktere záťaže sa do kapacitného plánovania prekladajú len ťažko.
Kompaktná AI stanica môže prevziať vývoj aj pravidelnú lokálnu prácu
Vo chvíli, keď firma potrebuje vlastné prostredie pre vývoj a pravidelnú lokálnu inferenciu, môžu systémy triedy GB10 pokryť niekoľko fáz projektu na jednom zariadení. Tím na nich môže overovať otvorené modely, prototypovať nad internými dátami a neskôr prevádzkovať stabilnú záťaž, ktorú už nechce zakaždým posielať do externej služby.
Platforma tejto triedy mieri hlavne na scenáre, ktoré sa do bežnej pracovnej stanice nezmestia pohodlne kvôli pamäťovým nárokom väčších modelov. Deklarovaných 200 miliárd parametrov však predstavuje orientačnú hranicu, pretože skutočné nároky sa menia podľa kvantizácie, dĺžky kontextu a spôsobu, akým aplikácia inferenciu obsluhuje.
Vyššia trieda prichádza s väčšími modelmi a náročnejšou prevádzkou
Keď rastú modely a dĺžka kontextu alebo sa projekt posunie k náročnejšiemu fine-tuningu, menia sa spolu s výkonovými nárokmi aj roly celej zostavy. Z osobného či tímového zariadenia sa postupne stáva zdieľaný výpočtový uzol, ktorý musí zapadnúť do širšej prevádzky firmy. Väčší význam potom získava sieťová konektivita a spôsob rozdeľovania dostupných prostriedkov medzi viacerých používateľov.
Do tejto výkonnostnej kategórie spadajú systémy s NVIDIA GB300 Grace Blackwell Ultra, napríklad GIGABYTE W775 alebo ASUS ExpertCenter Pro ET900N G3. Platforma DGX Station s GB300 ponúka až 748 GB koherentnej pamäte a výkon do 20 PFLOPS FP4, pričom NVIDIA ju spája s prácou s modelmi do jedného bilióna parametrov.
Rozhodovanie medzi jednotlivými triedami by preto malo vychádzať z reálneho využitia a očakávaného rastu. Menší tím môže kompaktnú platformu vyťažiť lepšie ako drahší systém s veľkou rezervou. Ak už pilot naráža na pamäťové limity alebo má projekt jasný plán rozšírenia, potrebná rezerva by mala byť súčasťou návrhu od začiatku.
Tabuľka 3: Porovnanie hlavných tried AI infraštruktúry
| Trieda zostavy | Pamäťová trieda | AI výkon | Orientačná veľkosť modelu | Typické použitie |
|---|---|---|---|---|
| GB10 / DGX Spark trieda | 128 GB zjednotenej pamäte | Až 1 PFLOP FP4 | Až 200 mld. parametrov | Lokálny vývoj, inferencie, agenti, piloty a menšie tímové scenáre |
| GB300 / DGX Station trieda | 748 GB koherentnej pamäte | Až 20 PFLOPS FP4 | Až 1 bilión parametrov | Väčšie modely, náročnejšie inferencie, fine-tuning a zdieľaný výkon |
| Klasická workstation s RTX GPU | Podľa konkrétnej konfigurácie | Podľa použitej GPU | Podľa VRAM, kvantizácie a workloadu | Profesionálne aplikácie kombinované s lokálnou AI |
| Serverová infraštruktúra | Podľa návrhu | Podľa počtu a typu akcelerátorov | Podľa architektúry riešenia | Produkčné služby pre viac tímov a vyššie nároky na dostupnosť |
Údaje o maximálnej veľkosti modelu predstavujú orientačnú hranicu danej platformy. Reálne nasadenie ovplyvňuje presnosť modelu, kvantizácia, dĺžka kontextu, súbežnosť aj charakter workloadu.
RAG ukazuje, prečo sa má validovať celý workload
Prečo samotný benchmark modelu často nestačí, dobre ukazuje firemný asistent nad internými dokumentmi. RAG, teda retrieval-augmented generation, pred vytvorením odpovede najskôr vyhľadáva relevantné informácie vo firemných zdrojoch a až potom ich odovzdáva modelu. Výkon výslednej služby tak závisí od celej dátovej cesty.
Jeden používateľský dotaz môže prejsť prevodom do embeddingu a vyhľadaním vhodných pasáží v databáze, po ktorom nasleduje ich zoradenie podľa relevancie a zostavenia kontextu pre model. Do výsledku súčasne vstupujú oprávnenia určujúce, aké podklady smie konkrétny používateľ získať. Pri dlhých dokumentoch navyše rastie tlak na pamäť a predlžuje sa cesta k výslednej odpovedi.
Validácia pre taký scenár preto potrebuje pracovať s podobnými vstupmi, aké sa očakávajú po nasadení. Pokiaľ produkčná služba obsluhuje dlhé dokumenty a viac používateľov súčasne, benchmark s krátkym promptom ukáže len malú časť skutočného správania systému.
!
Pokiaľ produkčná služba obsluhuje dlhé dokumenty a viac používateľov súčasne, benchmark s krátkym promptom ukáže len malú časť skutočného správania systému.
Meraný výkon potrebuje popísané podmienky
Tiež pri porovnávaní benchmarkov je nutné vedieť, za akých podmienok namerané číslo vzniklo. Rýchlosť v tokenoch za sekundu sa mení podľa použitého modelu a presnosti výpočtu. S dlhším vstupom alebo vyššou súbežnosťou sa správanie zostavy posunie znova, takže dve korektné merania môžu priniesť odlišné výsledky, a napriek tomu si navzájom neodporovať.
Pri interaktívnej službe navyše nestačí sledovať iba rýchlosť generovania po spustení odpovede. Pre používateľov býva zreteľný aj TTFT, teda čas do prvého tokenu, pretože dlhé čakanie na začiatok reakcie spomaľuje každodennú prácu. P95 a p99 latencie zase odhalia pomalšiu časť požiadaviek, ktorú bežný priemer ľahko skryje a ktorá sa často prejaví počas špičky.
Tabuľka 4: Metriky pre posúdenie výkonu AI služby
| Metrika | Čo ukazuje | Ako ju čítať v praxi |
|---|---|---|
| TTFT | Čas do prvej viditeľnej časti odpovede | Ovplyvňuje vnímanú svižnosť služby |
| Tokeny/s | Rýchlosť generovania výstupu | Pomáha posúdiť komfort používateľa a kapacitu |
| P95/p99 latencia | Odozvu pomalšej časti požiadaviek | Odhaľuje správanie v špičke lepšie ako priemer |
| Využitie pamäte | Rezervu pre model, kontext a ďalšie požiadavky | Často ukáže praktický limit zostavy |
| Dĺžka kontextu | Objem informácií držaných pri odpovedi | Ovplyvňuje pamäť aj rýchlosť |
| Súbežnosť | Počet paralelne obsluhovaných požiadaviek | Určuje použiteľnosť pri tímovej prevádzke |
Až spojenie týchto metrík s plánovanou prevádzkou ukazuje, či má nameraný výkon pre firmu skutočnú hodnotu. Z technických výsledkov sa tak prirodzene stávajú praktické otázky, ktoré je vhodné vyriešiť ešte pred výberom konkrétnej konfigurácie.
Čo si ujasniť pred výberom validovanej AI konfigurácie?
Pred výberom je vhodné poznať hlavný workload, ktorý má zostava obslúžiť, model alebo veľkostnú triedu modelov pripadajúcu do úvahy, typickú dĺžku vstupov a odpovedí, počet požiadaviek v špičke, prijateľnú odozvu pre používateľov, citlivosť dát vstupujúcich do promptov a logov, zodpovednosť za aktualizácie a monitoring a očakávaný rast využitia v nasledujúcich 12 až 24 mesiacoch.
Prečo môže rovnaký typ GPU podávať v praxi odlišný výkon?
Jazykový model potrebuje v pamäti priestor pre svoje váhy a počas inferencie pribúdajú ďalšie nároky spojené s kontextom alebo obsluhou súčasných požiadaviek. Rovnako výrazne dokáže výsledok zmeniť softvér – iná verzia ovládača alebo inferencie enginu môže ovplyvniť rýchlosť aj stabilitu a ďalšie rozdiely vznikajú podľa zvolenej kvantizácie alebo spôsobu práce s cache.
Čo je TTFT a prečo na ňom záleží?
TTFT je čas do prvého tokenu – teda do prvej viditeľnej časti odpovede. Pre používateľov býva citeľný, pretože dlhé čakanie na začiatok reakcie spomaľuje každodennú prácu. Pri interaktívnej službe preto nestačí sledovať iba rýchlosť generovania po spustení odpovede.
Prečo nestačí validovať iba model, ale celý workload?
Firemný asistent nad internými dokumentmi pracujúcimi na princípe RAG prechádza pred odpoveďou celou dátovou cestou – prevodom do embeddingu, vyhľadávaním pasáží, ich zoradením a zostavením kontextu pre model. Výkon výslednej služby tak závisí od celého reťazca, nie len od rýchlosti samotného modelu.
Kedy sa hodí kompaktná AI stanica triedy GB10 a kedy vyššia trieda?
Systémy triedy GB10 pokrývajú lokálny vývoj, inferenciu, agentov a pilotné projekty menších tímov. Keď rastú modely, dĺžka kontextu alebo sa projekt posunie k náročnejšiemu fine-tuningu a zdieľanej prevádzke viacerých používateľov, prichádza na rad vyššia trieda, ako sú systémy s GB300 Grace Blackwell Ultra.
Kde predtestovaná zostava šetrí čas a znižuje riziko
Najväčší prínos predtestovanej konfigurácie sa prejaví vo chvíli, keď firma už dokáže pomerne presne popísať svoju úlohu. Znalosť plánovaného modelu a typu dát umožní merať výkon, ktorý má pre daný projekt skutočný význam, a súčasne lepšie odhadnúť potrebnú rezervu pre rast.
V ranej fáze projektu môže byť výhodné rozbehnúť prvé experimenty v cloude, kde sa ľahko menia modely aj dostupná kapacita. Opakovaná záťaž potom poskytne podklady pre úvahy o vlastnej infraštruktúre. Keď tím pozná reálne prevádzkové špičky a približný objem práce, výber predtestovanej platformy stojí na konkrétnejších dátach.
Pri projektoch s citlivými informáciami sa k výkonu pridáva aj otázka kontroly nad tokom dokumentov, promptov a prevádzkových záznamov. Validácia samotnej zostavy bezpečnosť nevyrieši, pretože tá ďalej závisí od návrhu aplikácie a prístupových pravidiel firmy. Predvídateľné hardvérové a softvérové prostredie však dáva tímu stabilnejší základ, na ktorom môže tieto opatrenia stavať.
i
Kde sa ušetrí najviac práce
Najväčšia úspora zvyčajne vzniká ešte pred produkčným nasadením. Známa a podporovaná kombinácia hardvéru so softvérovým prostredím umožní tímu skôr začať merať skutočné riešenie vo firemnej prevádzke. Čas sa tak môže venovať kvalite dokumentov, typickým otázkam, správaniu používateľov a bezpečnostným pravidlám namiesto hľadania základných problémov s kompatibilitou.
Pred objednávkou AI zostavy je potrebné poznať konkrétny workload, rozsah overenia a podmienky, pri ktorých vznikli uvádzané výkonové výsledky. Ich spojenie ukáže, či dokumentácia poskytuje použiteľný základ pre plánovanú službu, alebo necháva zásadné otázky až na vlastné testovanie po nákupe. Dobre zdokumentovaná validácia pritom šetrí hlavne čas technického tímu, ktorý sa po dodaní môže skôr venovať meraniu, integrácii a správaniu riešení vo firemnom prostredí. Pokiaľ popis testu, podporovaného stacku a výkonových podmienok chýba, technické otázky sa iba presunú do fázy objednávky, kde býva ich riešenie pomalšie a drahšie.

Peter Vnuk
Technológie sú pre mňa prácou aj zábavou – najviac sa venujem smartfónom, notebookom, audiotechnike, umelej inteligencii a všetkému hi-tech. Rád recenzujem novinky, sledujem futuristické trendy a odhadujem ďalší vývoj technológií. Fascinuje ma sci-fi a vízie budúceho sveta, ktoré často inšpirujú reálny technologický pokrok. Profesionálne sa venujem aj videohrám a hernému priemyslu. Keď práve nepracujem, rád si odpočiniem pri dobrej hre, kvalitnom pive alebo tvorbe technologických memes na Facebooku.
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne

 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne
 Doručenie zdarma
Alzaboxy aj predajne